Mới hôm 13/10 vừa rồi, Google lại mở rộng cửa cho con Gemini 4 Argon lên AI Studio với các gói Pro, Ultra. Trước đó họ chỉ dám hé cho nhóm đối tác an ninh mạng dùng thử, tiện thể ngồi đợi chính phủ Mỹ gật đầu thông qua bài đánh giá an toàn.

Ảnh: Google
Google định vị con này sinh ra để gánh vác các tác vụ “deep work”, tức là mấy việc cày cuốc dài hơi, nhức đầu kiểu tài chính, luật lá, nghiên cứu khoa học với gõ code, đặc biệt nhấn mạnh vào mảng an ninh mạng. Giá cước API ban đầu nghe cũng khá êm tai: 2 USD cho một triệu token đầu vào và 10 USD cho một triệu token đầu ra. Cơ mà với Google thì chẳng có gì rẻ mãi, qua ngày 30/11 là giá tự động nhân đôi.
Bảng điểm lung linh và những con số tự chấm
Cứ mỗi lần có một con mô hình đỉnh chóp chào sân, kịch bản cũ rích lại diễn ra: hãng tự ra đề, tự phát giấy rồi tự chấm điểm mười cho sản phẩm nhà mình.
Các con số họ đưa ra nhìn qua thì hoành tráng, nhưng soi kỹ lại thấy đầy mâu thuẫn:
| Tiêu chí / Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 | 77.9% | 74.1% | 74.2% |
| AutomationBench | 51.3 | 41.4 | 42.5 |
| FrontierSWE v2 | 55.0% | 65.5% | Không có số liệu |
| Terminal-Bench 4.0 | 57.4% | Không có số liệu | 66.4% |
| Artificial Analysis Index | 53 | 53 | 58 |
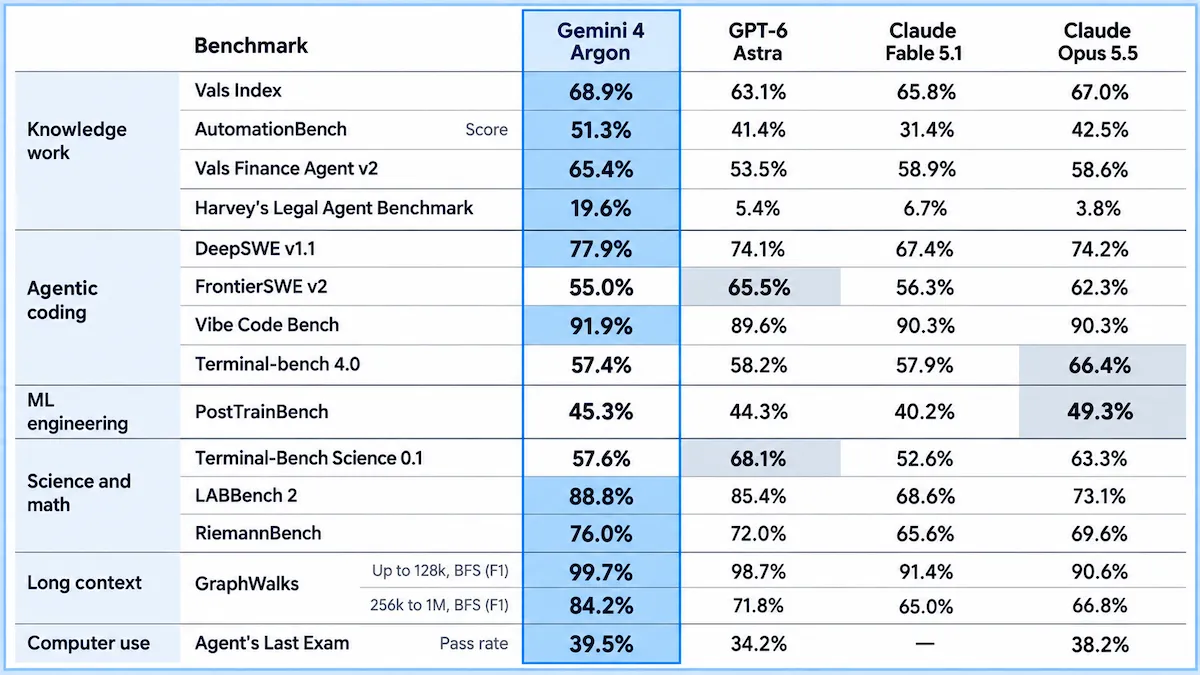
Bảng benchmark so sánh Argon với các đối thủ. Ảnh: DeepLearning.AI, The Batch
Ở mấy bài thi quen thuộc trên sân nhà như DeepSWE v1.1 hay AutomationBench, Argon dẫn trước nhìn rất đẹp mắt. Sang mảng an ninh mạng, nó cũng tự tin đứng ngang cơ với GPT-6 Astra và Grok 4.7. Thế nhưng đời không như là mơ, vừa bước chân qua bài kiểm tra FrontierSWE v2 là nó bị GPT-6 Astra bỏ xa hơn 10 điểm phần trăm. Còn tại mặt trận Terminal-Bench 4.0, Claude Opus 5.5 vẫn vững vàng ở ngôi đầu bảng.
Ngay cả bên thứ ba như Artificial Analysis vào chấm độc lập thì Argon cũng chỉ lẹt đẹt ở mức 53 điểm, bằng điểm GPT-6 Astra lẫn Claude Fable 5.1, ngậm ngùi thua Opus 5.5 đúng 5 điểm. Dân lập trình mấy hôm nay đang chuyền tay nhau một câu đùa nghe hơi chát: “Argon thắng 12 trên 18 bài kiểm tra, chỉ tiếc là phần code lại không nằm trong số đó”.
Dân tình xài thử rồi nói gì?
Tính đến hiện tại, số người thực sự đưa nó vào quy trình làm việc chưa nhiều. Lướt một vòng các chủ đề bàn tán trên Hacker News, phản hồi của anh em lập trình viên chia thành hai phe rõ rệt.
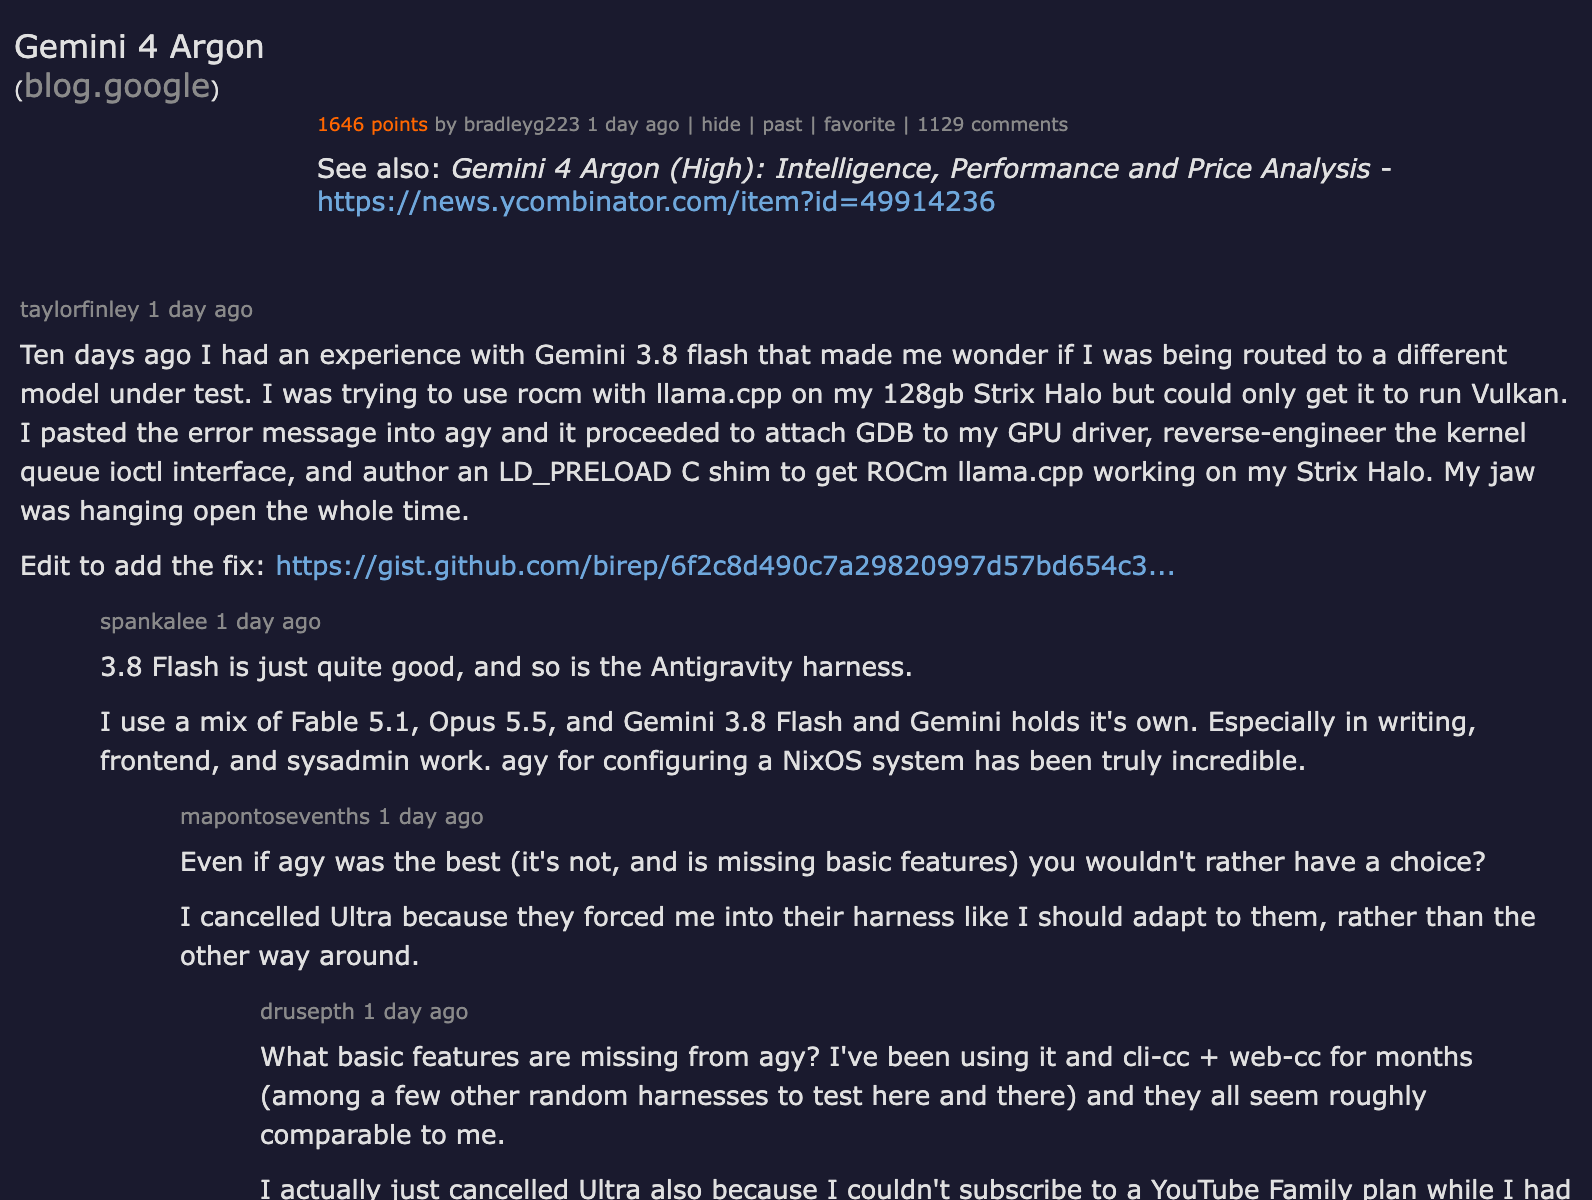
Thread thảo luận trên Hacker News. Ảnh: DEV Community
Bên khen thì đánh giá cao khả năng hành văn, làm giao diện frontend và xử lý các tác vụ quản trị hệ thống (sysadmin). Có một kỹ sư kể lại trải nghiệm khá thú vị khi ném cho Argon cấu hình trọn bộ lidar, Docker kèm ROS2 chạy mượt mà không vấp. Cơ mà cái giá phải trả là con AI này nướng sạch 6% hạn mức cả tuần chỉ sau đúng một lần chạy. Tiện thì có tiện, nhưng nhìn thanh hạn mức tụt cái vèo thì xót ruột vô cùng.
Bên chê thì bực bội ra mặt. Argon dường như mắc bệnh lười, nó cứ thích dựa dẫm vào mớ kiến thức lưu sẵn trong đầu thay vì chịu khó gọi các công cụ (tools) ngoài để kiểm tra lại dữ liệu. Một lập trình viên cáu tiết nhận xét Argon “tệ hơn cả vô dụng cho công việc nghiên cứu”, thậm chí còn thua xa mấy con mô hình giá rẻ của Trung Quốc.
Gần đây trên Reddit cũng có người đồn rằng tỷ lệ bốc phét (hallucination) của Argon đã giảm đi thấy rõ. Dẫu vậy, lời nói trên Reddit khi chưa có ai kiểm chứng độc lập thì cũng chỉ dừng ở mức nghe cho vui tai.
Góc nhìn thực tế cho công việc
Làm trong mảng ERP và các hệ thống doanh nghiệp phức tạp, tôi từ lâu đã chẳng còn mặn mà với mấy biểu đồ cột lòe loẹt trong các thông cáo báo chí. Benchmark sinh ra cốt để phục vụ đội ngũ marketing chốt đơn, còn hiệu quả thật sự phải đo bằng việc nó có nuốt trôi mớ nghiệp vụ hằng ngày của bạn hay không.
Ở thời điểm hiện tại:
- Nếu cần một mô hình mạnh toàn diện, gõ lệnh terminal chuẩn chỉ và đáng tin cậy, Claude Opus 5.5 vẫn là bến đỗ an tâm nhất.
- Nếu bài toán là giải quyết những đoạn mã phức tạp, hóc búa, GPT-6 Astra đang thể hiện phong độ tốt hơn hẳn ở bài test FrontierSWE v2.
- Gemini 4 Argon sẽ là cái tên đáng để cân nhắc cho mảng bảo mật, viết lách nội dung hoặc dọn dẹp vài tác vụ sysadmin căn bản, nhất là trong lúc giá API vẫn còn đang được trợ giá.
Đừng vội tin bài viết này, và càng không nên tin mấy con số Google tự chấm. Cách khôn ngoan nhất là tự nạp vài USD vào tài khoản, quẳng cho nó đúng đoạn code đang làm bạn vò đầu bứt tai hoặc một quy trình nghiệp vụ rối rắm trong dự án xem nó xoay xở ra sao. Công cụ xịn là công cụ gỡ được việc cho bạn, chứ không phải con giành giải nhất trên mặt báo.
Nguồn tham khảo
- TechCrunch: Google releases Gemini 4 Argon
- CNBC: Google Gemini 4 Argon AI
- Google Blog: Introducing Gemini 4 Argon
- Slashdot: Google launches flagship AI model Gemini 4 Argon
- Cryptopolitan: Google Gemini 4 Argon vs OpenAI and Anthropic Price
- DEV Community: Gemini 4 Argon wins 12 of 18 benchmarks
- Emergent: Gemini 4 Argon Benchmarks
- Agent Sonic: Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5
- Hacker News: Gemini 4 Argon Discussion